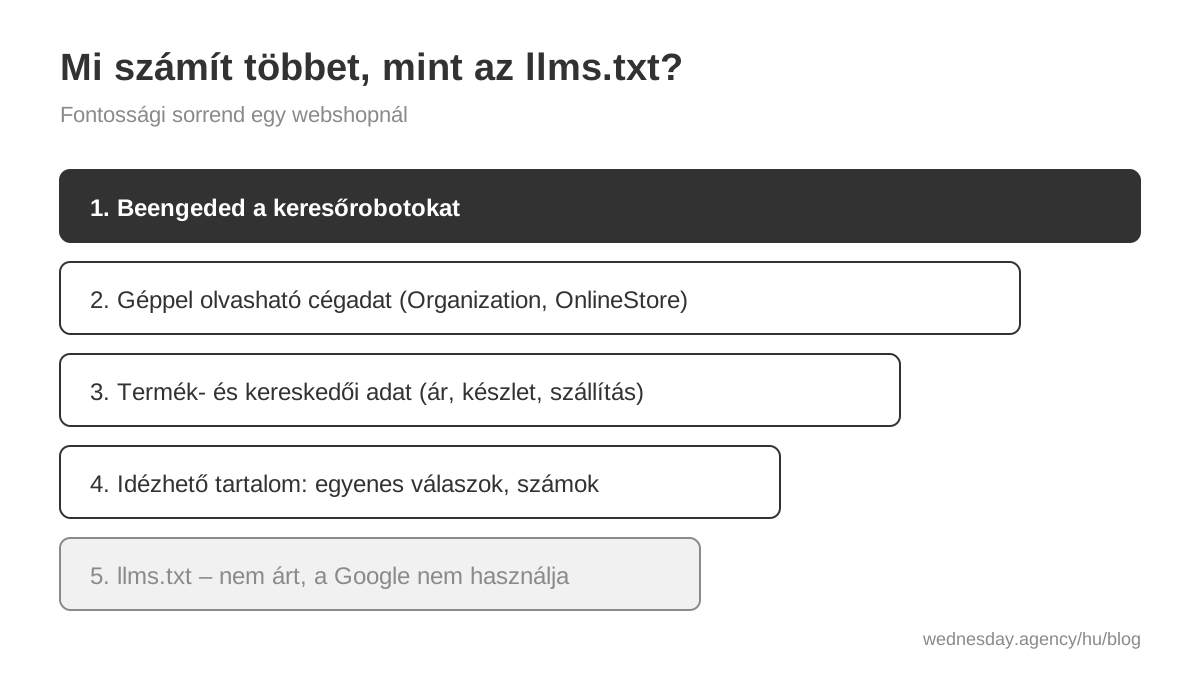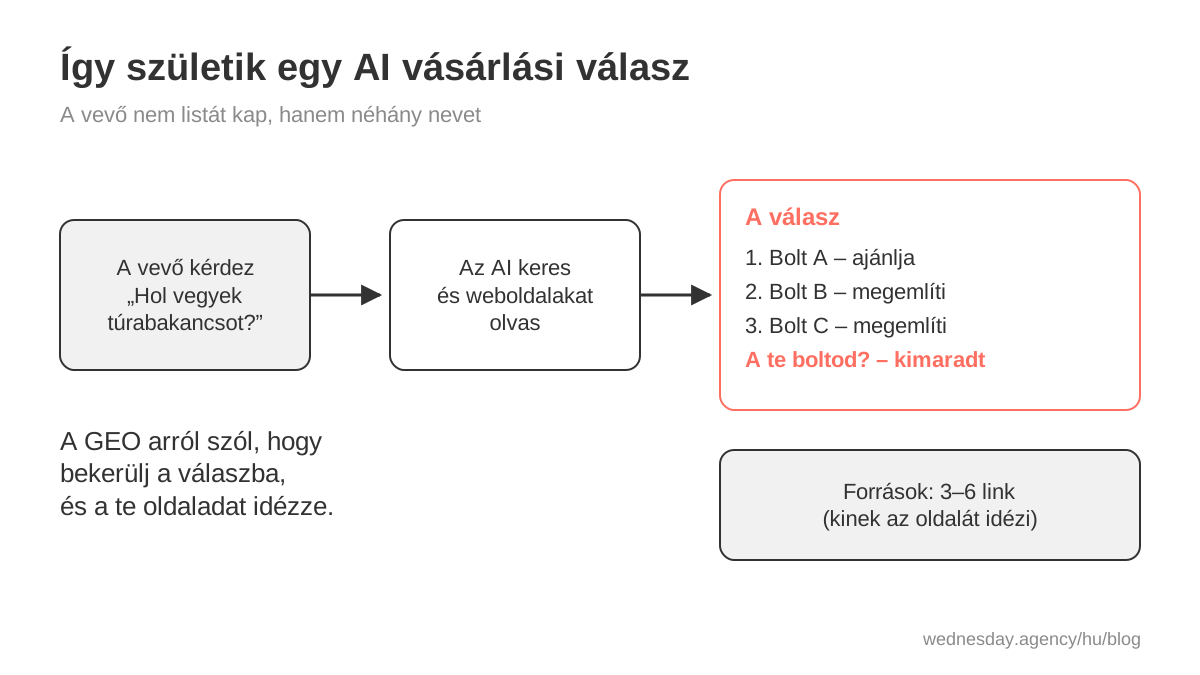
Az AI-cégeknek kétféle robotjuk van: a keresőrobot élő válaszokhoz olvas, a tanítórobot a modelleket tanítja. Ha a keresőrobot tiltva van, abból az AI-keresőből kimaradsz. A tanítórobot tiltása viszont nem rontja a megjelenést. A tiltás sokszor nem is a boltostól jön, hanem a tárhelytől vagy a Cloudflare-től.
Kétféle robot, kétféle döntés
Amikor egy AI „olvassa” az oldaladat, valójában egy robot (angolul crawler vagy bot) tölti le. Az AI-cégek külön robotot használnak a kereséshez és a tanításhoz, és mindegyik saját néven jelentkezik be. Így külön-külön dönthetsz róluk.
| Cég | Keresőrobot (élő válaszokhoz) | Tanítórobot (modelltanításhoz) |
|---|---|---|
| OpenAI (ChatGPT) | OAI-SearchBot | GPTBot |
| Anthropic (Claude) | Claude-SearchBot | ClaudeBot |
| Perplexity | PerplexityBot | – (a PerplexityBot nem tanít) |
| Googlebot (a keresővel közös) | Google-Extended* | |
| Common Crawl (sok AI ebből tanul) | – | CCBot |
* A Google-Extended nem külön robot, hanem egy név a robots.txt-ben: azt szabályozza, hogy a tartalmad tanítsa-e a Gemini modelleket, és felhasználható-e a Gemini válaszaihoz.
A cégek ezt saját oldalukon írják le: OpenAI, Anthropic, Perplexity, Google.
Az OpenAI és az Anthropic kifejezetten írja, hogy a tanítórobot tiltása független a kereséstől. Az OpenAI szerint például a beállítások „egymástól függetlenek”: ha a GPTBotot tiltod, a ChatGPT keresőjében attól még megjelenhetsz. A Google-nél a Google-Extended nem érinti a keresésben való megjelenést. A kereső AI-funkcióit (AI Mode, AI-összefoglaló) a Google szerint a Googlebot szabályai és a kivonatbeállítások (például nosnippet) irányítják.
Van egy harmadik fajta is: a felhasználó kérésére érkező robot (ChatGPT-User, Claude-User, Perplexity-User). Ez akkor jön, amikor valaki konkrétan a te oldaladra kérdez rá a csevegésben. Ezt se tiltsd.
Hol lehet tiltva? Három kapu
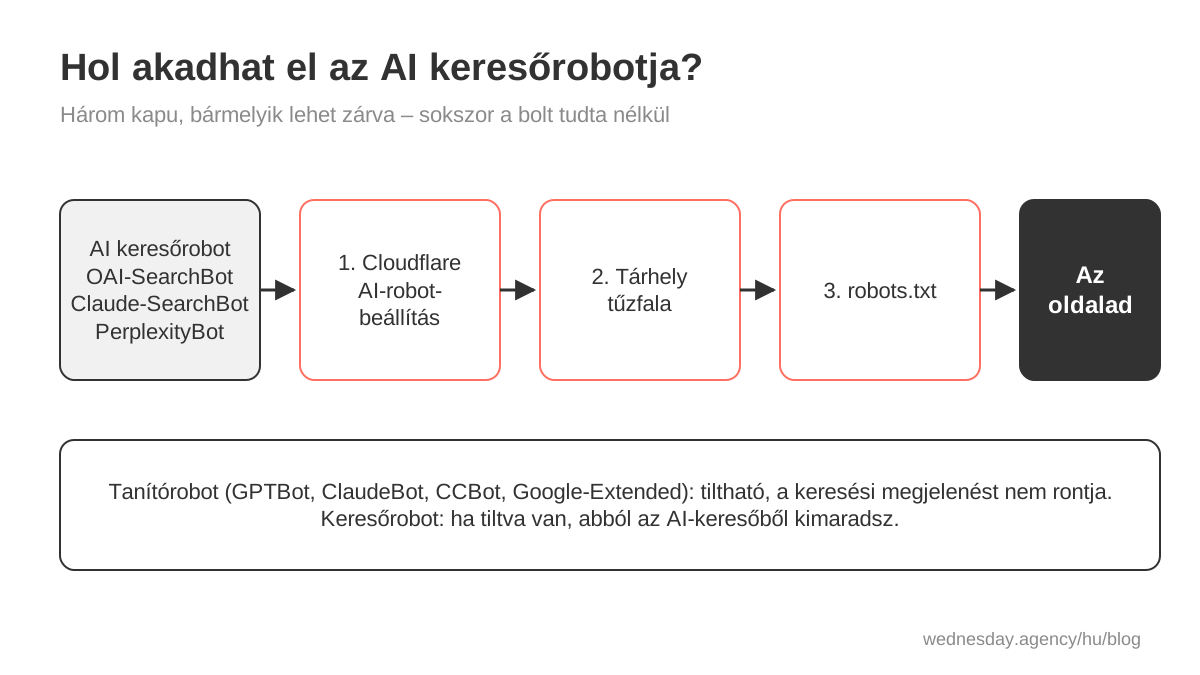
1. A Cloudflare. Ha az oldalad Cloudflare mögött van, nézd meg az AI-robotokra vonatkozó beállítást. A Cloudflare 2025. július 1. óta az új domaineknél rákérdez, beengedi-e a tulajdonos az AI-robotokat, és alapból a tiltás felé terel. Ha akkor valaki gyorsan rákattintott, lehet, hogy azóta minden AI-robot ki van zárva.
2. A tárhely tűzfala. Egyes tárhelyszolgáltatók a saját védelmükben robotszűrőt futtatnak, és ez az AI-robotokat is megfoghatja. Ezt a tárhely ügyfélszolgálatánál lehet megkérdezni.
3. A robots.txt. Ez az a fájl, amit a bolt maga állít be (vagy a webshopmotor). Ezt látod a legkönnyebben.
A Google is felhívja rá a figyelmet, hogy a robots.txt mellett a CDN-t (például a Cloudflare-t) és a tárhelyet is nézd meg.
Így nézd meg a robots.txt-t 2 perc alatt
- Írd be a böngészőbe:
https://tedomained.hu/robots.txt - Keresd meg ezeket a neveket:
OAI-SearchBot,Claude-SearchBot,PerplexityBot,Googlebot. - Ha valamelyik alatt ez áll:
Disallow: /, az a robot nem olvashatja az oldaladat. - Nézd meg a
User-agent: *sort is. Ha alattaDisallow: /áll, az minden robotot kizár, a nevesítetteket kivéve.
Egy rendben lévő, egyszerű beállítás így néz ki:
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /
Disallow: /kosar/
Disallow: /fiokom/

User-agent: *
Disallow: /kosar/
Disallow: /fiokom/
A kosarat és a fiókoldalakat nyugodtan kizárhatod, azokat nem kell idéznie senkinek. Figyelj: a név szerint megadott robot csak a saját csoportjának szabályait követi, ezért a kizárásokat ott is meg kell ismételni.
Ha a robots.txt rendben van, a Cloudflare-t és a tárhelyet viszont nem tudod ellenőrizni, kérd meg a fejlesztődet, vagy kérd az ingyenes villámtesztet.
Mit érdemes beállítani?
- Keresőrobotok: be. Webshopnál szinte mindig ez a jó döntés. Ha kitiltod őket, a vevőd AI-ja nem fog tudni rólad.
- Felhasználói robotok: be. Ezek csak akkor jönnek, ha valaki rád kérdez.
- Tanítórobotok: te döntesz. Ha a szövegeid, termékleírásaid a saját értéked, és nem akarod, hogy modellt tanítsanak velük, tiltsd. Ha azt szeretnéd, hogy a jövőbeli modellek kereséstől függetlenül is ismerjék a boltodat, engedd be. Egyik sem hiba.
Ami csak kérés, nem szabály
Két újdonságról sokat hallani, ezért érdemes tisztázni:
- A Cloudflare Content Signals egy megjegyzés a robots.txt-ben, amivel jelezheted, mire használhatják a tartalmadat (keresés, AI-bemenet, tanítás). A Cloudflare maga írja, hogy ez kérés, nem kényszer.
- Az IETF aipref egy szabványtervezet ugyanerre. Egyelőre munkacsoporti szakaszban van.
Egyiket sem kötelező használni. A robots.txt és a robotok saját nevei ma is működnek.
A Google-nél egy plusz beállítás
A Google AI-funkcióit nem a robots.txt-ben lehet külön kikapcsolni, hanem a Search Console-ban, a Search generative AI beállításnál. Ez alapból bekapcsolt állapotban van, de érdemes megnézni, nem kapcsolta-e ki valaki. Erről a SEO vagy GEO? cikkben írunk.
Gyakori kérdések
Ha kitiltom a GPTBotot, kimaradok a ChatGPT-ből? A ChatGPT kereséséből nem: azt az OAI-SearchBot intézi. A GPTBot tiltásával azt jelzed, hogy a tartalmad ne kerüljön a modelltanításba.
Honnan tudom, hogy a Cloudflare tilt-e? A Cloudflare irányítópultján, a robotokra vonatkozó beállításoknál. Ha nem te kezeled a fiókot, kérdezd meg azt, aki az oldalt beállította.
Elég egyszer beállítani? Érdemes negyedévente ránézni. Új tárhely, új bővítmény vagy egy Cloudflare-frissítés átállíthatja.
Az llms.txt nem ugyanerre való? Nem. Az llms.txt egy bemutatkozó fájl, nem engedélyez és nem tilt semmit. Lásd: Kell-e llms.txt a webshopodra?
Nézzük meg együtt
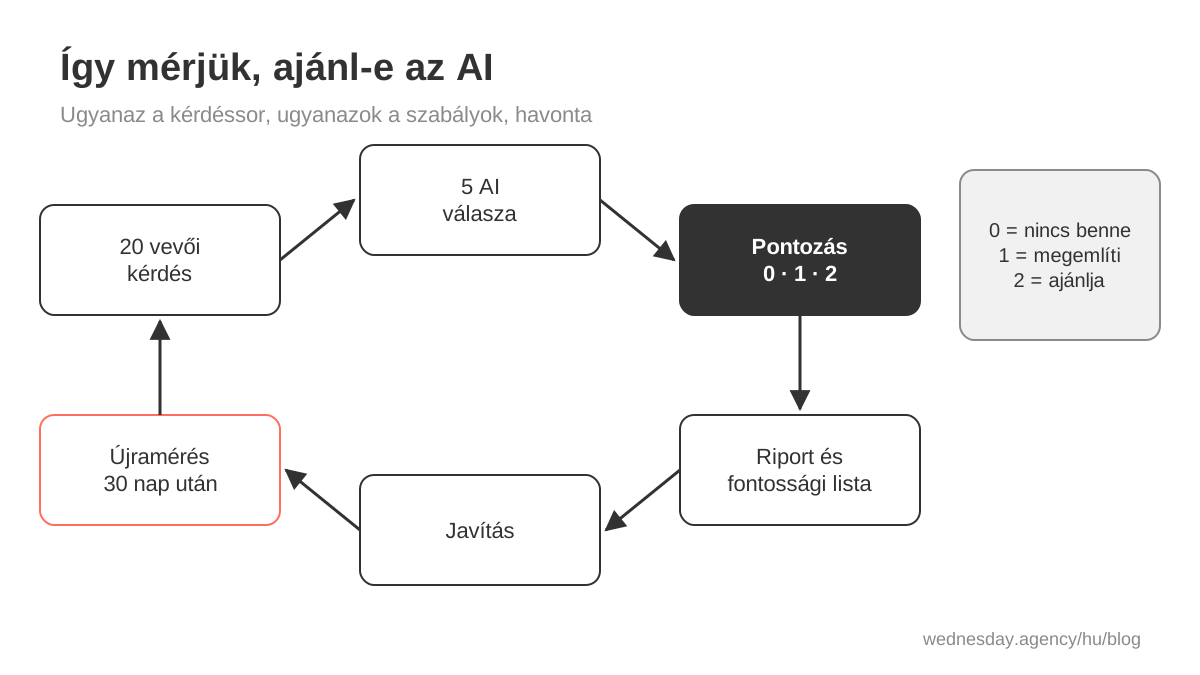
A villámteszt egy vevői kérdést tesz fel a ChatGPT-nek és a Google AI Mode-nak, és megmutatja a legfontosabb gépi hibát az oldaladon. Ha rendszeresen figyelni akarod, a mérésről szóló cikkben leírjuk, hogyan. A szolgáltatás a GEO-oldalon van.
Utoljára ellenőrizve: 2026. október 20.
A cikk elkészítését mesterséges intelligencia (AI) is segítette.